Aller au contenu
Première fiche gratuite dans chaque formation Cours guidés, à votre rythme Contenus gratuits dès 8 ans Fait en France

Ressources

Comprendre avant de mémoriser

Une idée par carte. L'analogie d'abord, le détail au clic. Puis l'atlas : qui joue quel rôle.

Comprendre en clair

Le complexe, en une idée

Comment l'IA génère du texte

L'IA n'écrit pas une phrase entière d'un coup : elle la devine un petit bout à la fois, comme on complète un mot sur le bout de la langue.

L'image à retenir

C'est comme le texto qui suggère le mot suivant au-dessus de ton clavier, mais en bien plus malin : à chaque mot tapé, il propose la suite la plus probable. Sauf que l'IA enchaîne ces suggestions des centaines de fois pour écrire des paragraphes entiers, en gardant en tête tout ce qui a déjà été écrit. Et comme ton clavier, elle propose parfois un mot très crédible... mais totalement à côté.

Le cours →
Un peu plus

Quand l'IA écrit, elle ne pense pas à ce qu'elle va dire : elle prédit juste le prochain « morceau » de texte (un mot ou un bout de mot, qu'on appelle un token), puis le suivant, et ainsi de suite. Pour bien choisir, elle relit tout ce qui précède et décide quels mots comptent le plus à cet instant : c'est le mécanisme d'« attention », le cœur d'une architecture appelée Transformer, qui regarde toute la phrase d'un coup au lieu de la lire de gauche à droite. À force d'avoir vu des montagnes de textes, elle a appris quelles suites de mots sont les plus probables, et elle rejoue cette intuition à chaque pas. C'est puissant parce que prédire le mot suivant l'oblige, sans qu'on le lui demande, à apprendre la grammaire, le sens, le style et des tonnes de connaissances. Mais c'est aussi sa faiblesse : elle cherche ce qui « sonne juste » et probable, pas ce qui est vrai, et rien ne vérifie un fait au passage. Quand elle ne sait pas, elle comble quand même le trou avec la suite la plus plausible : c'est ça, une « hallucination ».

Comment l'IA crée des images

Pour dessiner un chat, l'IA ne part pas d'une page blanche : elle part d'un écran de neige télé et le « débrouille » jusqu'à voir un chat apparaître.

L'image à retenir

C'est comme un sculpteur devant un bloc de marbre brut : il n'ajoute rien, il enlève de la matière petit à petit jusqu'à ce que la statue apparaisse. Votre prompt, c'est le croquis posé à côté qui lui dit quoi dégager, sauf que pour les doigts, le croquis est flou, alors il en sculpte parfois six.

Le cours →
Un peu plus

Au départ, l'IA affiche un fouillis de points aléatoires, comme la « neige » d'une vieille télé sans signal. Pendant son entraînement, on lui a montré des millions d'images qu'on a peu à peu noyées sous ce grain, et elle a appris à faire l'inverse : retirer un peu de bruit à chaque fois. Pour générer une image, elle répète donc ce nettoyage des dizaines de fois ; à chaque étape elle devine « si je gomme un peu de grain, qu'est-ce qui se cache là-dessous ? », et une forme se précise pas à pas. Votre texte (le prompt) sert de boussole : à chaque coup de gomme, l'IA compare ce qu'elle voit avec vos mots et oriente le débruitage vers « un chat roux » plutôt que vers autre chose. Pour aller vite, elle ne travaille pas sur les millions de pixels finaux mais sur une version compressée et résumée de l'image, un brouillon interne appelé espace latent, qu'un dernier module traduit en image nette. Les mains ratent souvent parce qu'elles sont petites, rares et tordues dans tous les sens sur les photos d'entraînement : l'IA a vu des doigts mais n'a jamais compris qu'une main en a exactement cinq.

Comment l'IA génère des vidéos

Une vidéo IA, ce n'est pas un film qu'on tourne : c'est du « bruit » télévisuel que la machine sculpte image par image jusqu'à ce qu'un monde apparaisse.

L'image à retenir

Imagine un sculpteur devant un bloc de neige granuleuse (le bruit). Pour une photo, il dégage une seule statue. Pour une vidéo, il doit sculpter une rangée de statues légèrement différentes, en s'assurant que, mises bout à bout, elles donnent l'illusion d'un seul personnage qui bouge en douceur. Et plus la séquence est longue, plus il y a de blocs à tailler, image après image : d'où l'effort énorme.

Le cours →
Un peu plus

L'IA part d'un écran rempli de grésillement aléatoire, comme une vieille télé sans antenne, et le nettoie petit à petit jusqu'à révéler l'image demandée : c'est ce qu'on appelle la diffusion. Pour une vidéo, le défi en plus est le temps : il ne suffit pas de faire une belle image, il faut que toutes les images de la séquence s'enchaînent sans que les objets se déforment ou changent de couleur d'un instant à l'autre. Pour y arriver, des modèles comme Sora (OpenAI) ou Veo (Google) ne traitent pas chaque image isolément : ils découpent la vidéo en petits cubes d'« espace-temps » et les génèrent ensemble, en regardant à la fois ce qui se passe à côté et juste avant et après. C'est cette vision globale qui donne la cohérence : un chien reste le même chien quand il court, et une ombre bouge logiquement. Le revers, c'est le coût : une seule seconde de vidéo contient des dizaines d'images, chacune nettoyée des dizaines de fois, ce qui demande une puissance de calcul colossale. Voilà pourquoi quelques secondes de vidéo IA peuvent coûter autant que des centaines d'images fixes et tournent sur des fermes de processeurs graphiques très chers.

Comment l'IA comprend et imite la voix

En quelques secondes d'enregistrement, une machine peut aujourd'hui apprendre à parler avec votre voix : voici comment elle entend, et comment elle imite.

L'image à retenir

Comprendre la voix, c'est comme un musicien qui écoute un air et écrit les notes sur une partition. Parler, c'est l'inverse : un autre musicien lit la partition et rejoue l'air. Le clonage vocal, c'est quand ce second musicien a écouté votre façon de jouer pendant dix secondes et peut désormais rejouer n'importe quelle chanson exactement avec votre « son » à vous.

Le cours →
Un peu plus

La voix par l'IA, ce sont deux trajets opposés. Pour COMPRENDRE (on dit « speech-to-text »), un modèle comme Whisper d'OpenAI transforme le son en une sorte d'image des fréquences (un « spectrogramme »), puis devine mot après mot ce qui a été dit ; il a appris en écoutant 680 000 heures d'audio aspirées sur le web. Pour PARLER (« text-to-speech »), c'est l'inverse : l'IA fabrique d'abord cette image-son à partir du texte, puis un « vocodeur neuronal » (comme WaveNet) la retransforme en vraie onde sonore, avec un timbre naturel. Le clonage vocal ajoute une touche : on montre au modèle un court extrait d'une voix réelle, et il apprend à appliquer ce timbre à n'importe quelle phrase. C'est ce dernier point qui crée le danger : quelques secondes suffisent à imiter quelqu'un, et des escrocs s'en servent pour appeler en se faisant passer pour un proche en détresse, une fraude qui a explosé ces dernières années.

Ce qui distingue vraiment les grands LLM

Deux IA peuvent réciter la même réponse et pourtant ne pas jouer dans la même cour : la vraie différence se cache dans ce qu'on ne voit pas.

L'image à retenir

Pensez à une équipe de cuisine. Le nombre de paramètres, c'est la taille de la brigade ; mais une petite brigade bien formée bat une grande mal entraînée (la qualité des données). Un modèle dense réveille tous les cuisiniers pour chaque plat ; un Mixture-of-Experts n'appelle que le pâtissier pour un dessert et le rôtisseur pour une viande, donc c'est plus rapide. La fenêtre de contexte, c'est la taille du plan de travail : trop petit, et on perd les ingrédients posés au début de la recette. Et un modèle de raisonnement, c'est le chef qui goûte et corrige avant d'envoyer l'assiette, au lieu de la servir d'un coup.

Le cours →
Un peu plus

Un grand modèle de langage (LLM), c'est une IA qui a appris à manier le langage en lisant d'énormes quantités de textes. Quatre choses les séparent vraiment. D'abord la taille : on la mesure en "paramètres", les milliards de petits réglages internes du modèle ; plus il y en a, plus il peut retenir de nuances, mais ce qui compte aussi c'est la qualité des données lues, pas seulement leur quantité. Ensuite l'architecture : un modèle "dense" fait travailler tous ses paramètres à chaque mot, tandis qu'un modèle "Mixture-of-Experts" n'allume qu'une poignée de spécialistes selon la question, ce qui le rend plus rapide et moins coûteux à capacité égale. Vient la fenêtre de contexte : la quantité de texte que le modèle peut "garder sous les yeux" en même temps (mesurée en tokens, des petits morceaux de mots) ; plus elle est large, plus il peut lire un long document sans en oublier le début. Enfin, certains sont des modèles de "raisonnement" : avant de répondre, ils réfléchissent étape par étape en interne, ce qui les rend bien meilleurs en maths, en code et en logique, mais plus lents et plus chers. Résultat : il n'existe pas de "meilleur" modèle dans l'absolu, seulement le mieux adapté à votre usage.

Pourquoi certains modèles « réfléchissent »

Et si la différence entre une bonne et une mauvaise réponse, c'était simplement quelques secondes de « réflexion » avant de parler ?

L'image à retenir

C'est la différence entre deux élèves face à un problème de maths. Le premier lève la main tout de suite et lance la première réponse qui lui passe par la tête. Le second prend son brouillon, écrit ses étapes, vérifie son calcul, rature, recommence, puis donne sa réponse. Le second est plus lent et use plus de papier, mais il se trompe beaucoup moins. Un modèle de raisonnement, c'est l'élève qui sort son brouillon.

Le cours →
Un peu plus

Un modèle d'IA classique répond du tac au tac : il crache le premier enchaînement de mots qui lui semble probable, sans s'arrêter. Les modèles dits « de raisonnement » (comme o1 et o3 d'OpenAI, ou DeepSeek-R1) font autre chose : avant de te donner leur réponse finale, ils écrivent pour eux-mêmes une longue suite d'étapes, un brouillon de pensée appelé « chaîne de raisonnement ». Ils posent le problème, testent une piste, se corrigent, vérifient, et ce n'est qu'ensuite qu'ils répondent. Ce brouillon est en grande partie caché, mais c'est lui qui fait la différence : sur les maths, le code ou la logique, ces modèles sont nettement plus justes. La contrepartie est réelle : « penser » prend du temps et coûte cher, car chaque étape de réflexion est du texte généré qu'il faut produire et facturer. Du coup on les réserve aux questions difficiles, et on garde les modèles rapides pour les tâches simples.

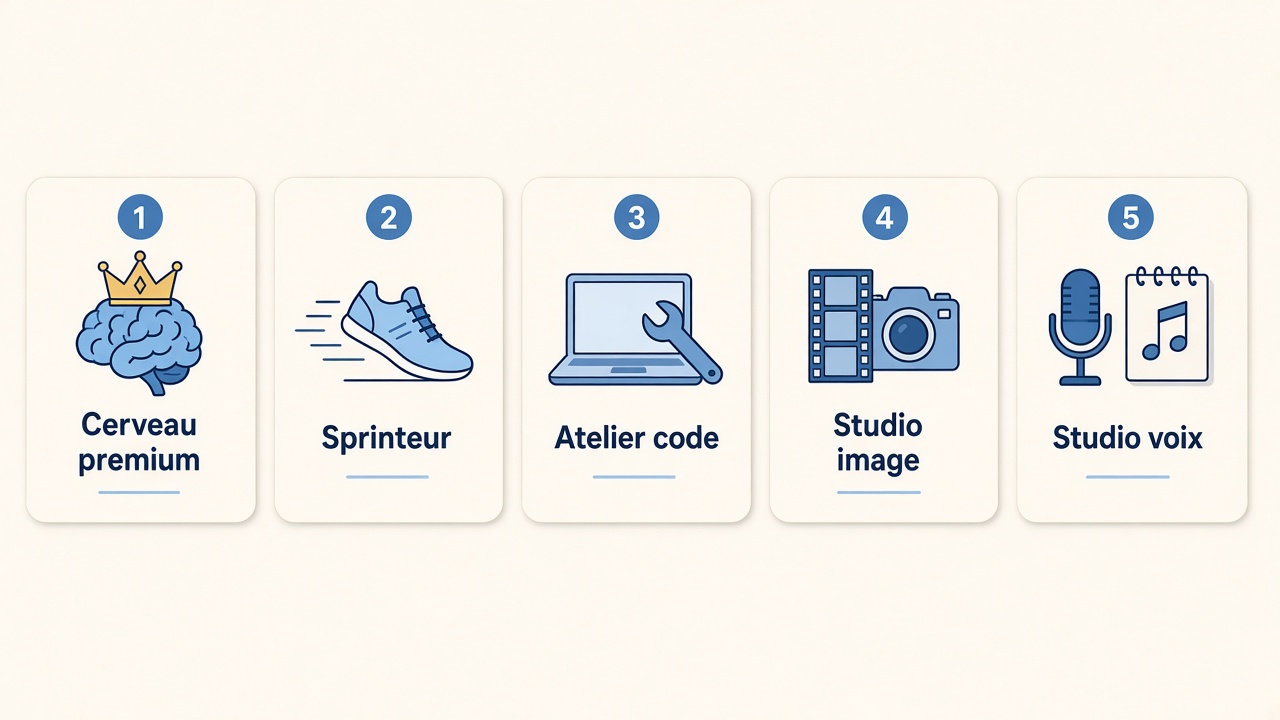
Cinq métiers de l'IA

Avant les marques, les rôles

Les cinq rôles : cerveau premium, sprinteur, atelier code, studio image, studio voix
Une seule question utile : « de quel rôle parle-t-on ? »
Panorama

Qui fait quoi

GPT (OpenAI)

Fermé

Cerveau premium · Sprinteur · Studio image · Studio voix

C'est l'assistant IA le plus connu au monde, le moteur de ChatGPT. Il écrit, répond, code, analyse des images, parle en direct et raisonne sur des problèmes difficiles. Sa force : une gamme à trois étages, du plus profond au moins cher, que l'on choisit selon la tâche.

OpenAI, entreprise américaine basée à San Francisco (créatrice de ChatGPT) USA

Analogie & détail
L'image

C'est un peu comme une équipe de cuisine à trois niveaux : le chef étoilé pour les plats les plus délicats, le cuisinier polyvalent pour le quotidien, et le commis rapide pour servir beaucoup de monde sans y passer la nuit.

Fin octobre 2026, la gamme de référence est GPT-6 : Astra (le plus exigeant, lancé le 3 septembre 2026 selon la presse), GPT-6.1 Sol (l'équilibre) et GPT-6 Luna (le petit prix). Ces trois modèles lisent texte et image, répondent en texte, et gèrent environ 1 million de tokens de contexte. Côté médias, GPT Image 2.5 (septembre 2026) fait l'image, GPT-Live 1 la voix en direct. À l'inverse, Sora, le générateur de vidéo, a été arrêté en 2026.

Claude (Anthropic)

Fermé

Cerveau premium · Atelier de code · Sprinteur

Claude est un assistant IA conversationnel qui excelle à écrire, raisonner, analyser de longs documents et surtout coder. Sa marque de fabrique : être à la fois très capable et particulièrement prudent et honnête, conçu pour rester utile sans déraper.

Anthropic, entreprise américaine fondée en 2021 par d'anciens d'OpenAI (dont Dario et Daniela Amodei). USA

Analogie & détail
L'image

C'est un peu comme un collègue brillant et hyper consciencieux : ultra-doué pour les tâches difficiles (surtout la programmation), mais qui préfère dire « je ne suis pas sûr » plutôt que d'inventer, et qui réfléchit avant de répondre.

Fin octobre 2026, la gamme actuelle compte quatre modèles : Claude Fable 5.1 (raisonnement exigeant et agents de longue haleine), Opus 5.5 (code agentique et travail de connaissance), Sonnet 5.5 (le meilleur équilibre vitesse et intelligence) et Haiku 5.5 (le plus rapide, pour le volume). Tous lisent texte et image, répondent en texte et gèrent 1 million de tokens de contexte. Particularité maison : Claude est entraîné avec une charte écrite de principes (« Constitutional AI ») qui le guide vers des réponses honnêtes et inoffensives.

Gemini (Google)

Fermé

Cerveau premium · Sprinteur · Studio image · Studio voix

Gemini est l'assistant IA tout-terrain de Google : il comprend et raisonne sur du texte, des images, du son, de la vidéo et du code. Sa grande force : une famille qui couvre aussi la voix en direct, l'image, la vidéo et la musique, et qui s'intègre dans les produits Google (Recherche, Gmail, Docs, Android).

Google DeepMind, la division IA de Google (États-Unis) USA

Analogie & détail
L'image

C'est un peu comme un assistant personnel qui aurait étudié dans toutes les matières à la fois (texte, dessin, musique, films) et qui vit déjà dans tous vos outils du quotidien : au lieu d'aller le chercher, il est déjà à côté de vous dans votre boîte mail, vos documents et votre téléphone.

Le modèle phare de fin octobre 2026 est Gemini 4 Argon, présenté fin septembre et listé comme stable dans la documentation pour développeurs (contexte annoncé : 1 million de tokens). Gemini 3.8 Flash, rapide et économique, couvre le quotidien. Le Gemini 3.5 Pro annoncé en mai 2026 ne sortira finalement pas, selon la presse. Côté création, Nano Banana 2.1 fait l'image, Gemini Omni Flash la vidéo avec son, Lyria 3.5 les chansons.

Mistral (Mistral AI)

Ouvert

Cerveau premium · Atelier de code · Sprinteur · Studio voix

C'est une famille d'intelligences artificielles qui comprennent et écrivent du texte, codent, analysent des images et des documents, et parlent. Sa grande force : des modèles efficaces et souvent « ouverts » (téléchargeables et installables par n'importe qui), portés par le champion européen de l'IA, avec un fort attachement à la souveraineté et à la confidentialité des données.

Mistral AI, jeune entreprise française fondée en 2023 à Paris par d'anciens chercheurs de Meta et Google DeepMind (Arthur Mensch, Guillaume Lample, Timothée Lacroix). France

Analogie & détail
L'image

C'est un peu comme un grand chef cuisinier qui, au lieu de garder ses recettes secrètes, vous offre le livre de recettes complet : vous pouvez cuisiner chez vous, à votre façon. Là où d'autres IA restent enfermées dans leur restaurant, Mistral vous laisse emporter le savoir-faire à la maison.

Le 6 octobre 2026, Mistral a présenté Mistral Large 4, un modèle d'environ 1 000 milliards de paramètres, son plus gros à ce jour. Ses poids ouverts étaient annoncés quelques semaines plus tard, après des tests de sécurité : à vérifier avant de s'appuyer dessus. Le reste de la gamme actuelle comprend Medium 3.5 (avril 2026), Small 4 (mars 2026) et la voix avec Voxtral. Devstral 2 et Magistral, eux, sont en cours de retrait ou retirés.

Muse et Llama (Meta)

Ouvert

Cerveau premium · Atelier de code (souvent ouvert)

Meta est connue pour avoir mis une IA de niveau professionnel entre les mains de tous avec Llama, des modèles que n'importe qui peut télécharger pour les faire tourner sur ses propres machines. Depuis 2026, sa nouvelle famille s'appelle Muse, développée par Meta Superintelligence Labs, avec des modèles fermés et des modèles ouverts.

Meta (la maison de Facebook, Instagram et WhatsApp), États-Unis USA

Analogie & détail
L'image

C'est un peu comme une grande chaîne de boulangeries qui a longtemps distribué sa recette gratuitement, puis qui garde sa recette phare au fournil mais continue d'en publier des versions à reproduire chez soi, si l'on a un four assez grand.

Muse Spark, lancé en avril 2026, est un modèle fermé. Muse Glimmer (août 2026) est un petit modèle ouvert sous licence Apache 2.0. Le 15 octobre 2026, Meta a publié Muse Spark Open : 816 milliards de paramètres au total (42 milliards actifs), 1 million de tokens de contexte, sous une licence maison. Il lui faut au moins 1 To de mémoire. La dernière famille Llama vérifiée reste Llama 4 (2025) ; nous n'avons trouvé aucune confirmation sérieuse d'un Llama 5.

DeepSeek

Ouvert

Cerveau premium · Atelier de code · Sprinteur (ouvert)

DeepSeek crée des modèles d'IA très puissants capables de discuter, coder et raisonner étape par étape, qu'il publie gratuitement et librement (« open-weight »). Sa force : offrir un niveau proche des meilleurs modèles fermés américains, mais pour une fraction du coût.

DeepSeek, un laboratoire d'IA chinois basé à Hangzhou, fondé en 2023 par Liang Wenfeng et financé par le fonds spéculatif High-Flyer (Chine). Chine

Analogie & détail
L'image

C'est un peu comme un grand chef étoilé qui, au lieu de garder ses recettes secrètes, les distribue gratuitement à tout le monde : tout le monde peut cuisiner le même plat chez soi, sans payer le restaurant de luxe.

Début 2025, son modèle de raisonnement R1 a créé un choc mondial. La génération actuelle est V4 : DeepSeek-V4-Pro (1 600 milliards de paramètres, 1 million de tokens de contexte, licence MIT, version officielle d'août 2026) et V4-Flash, remplacé en septembre 2026 par V4.1-Flash. La documentation officielle montre aussi que les anciens noms d'API sont redirigés vers les nouveaux modèles : un bon rappel qu'il faut toujours vérifier la version exacte.

Grok (xAI)

Fermé

Cerveau premium · Atelier de code · Studio image · Studio voix

Grok est un assistant IA conversationnel intégré au réseau social X (ex-Twitter). Sa grande force : un accès en temps réel à ce qui se dit sur le web et sur X, plus un ton volontairement vif, drôle et moins « lissé » que ses rivaux.

xAI, la société d'intelligence artificielle d'Elon Musk, basée aux États-Unis. USA

Analogie & détail
L'image

C'est un peu comme l'ami branché et taquin qui est toujours au courant de la dernière actu et des dernières tendances : il répond avec humour et franc-parler, là où les autres assistants restent plus sages et prudents.

Selon la documentation officielle, le modèle recommandé pour le code et la conversation est Grok 4.7 (contexte de 500 000 tokens, connaissances jusqu'en mai 2026). Grok Build 0.1 vise le développement, et la plateforme couvre aussi l'image (Imagine image 2.0), la vidéo (Imagine vidéo 1.5) et la voix de bout en bout (Voice 3.0). Les anciennes versions restent listées avec d'autres caractéristiques.

Qwen (Alibaba)

Ouvert

Cerveau premium · Sprinteur · Studio image · Studio vidéo

Qwen (« Tongyi Qianwen ») est une grande famille d'IA qui comprend et génère du texte, du code, des images et de la voix, en plus de 100 langues. Sa force : de nombreux modèles très performants que (presque) tout le monde peut télécharger et utiliser, parfois même pour des projets commerciaux.

Alibaba Cloud (groupe Alibaba), le géant chinois du e-commerce et du cloud Chine

Analogie & détail
L'image

C'est un peu comme une immense bibliothèque en libre accès, ouverte par un grand groupe : au lieu de garder ses livres sous clé, Alibaba en prête beaucoup au monde entier, qui peut les copier, les adapter et les améliorer. Les plus précieux restent toutefois dans la réserve.

La génération actuelle est Qwen3.8 : Qwen3.8-Max (fermé, août 2026, accessible par le cloud d'Alibaba), Qwen3.8-Flash et Qwen3.8-Omni-Flash (voix et multimodal), avec aussi Qwen3.7-Plus. Côté création, Qwen-Image 3.0 Pro fait l'image et Wan 3.0 la vidéo. Plusieurs modèles ouverts ont suivi en août 2026 (Qwen3.8-27B sous licence Apache 2.0, par exemple), chacun avec sa licence : à lire avant de s'en servir.

Comparer sans se noyer

On regarde au minimum

  • famille de modèle vs version exacte
  • qualité de raisonnement
  • qualité de code
  • multimodalité
  • image / vidéo / voix / musique
  • latence
  • coût
  • contexte long
  • outils et agents
  • hébergement et open-weight
  • langues et localisation
  • contrôle, garde-fous et dépréciations
Ouvrir l'atlas détaillé